
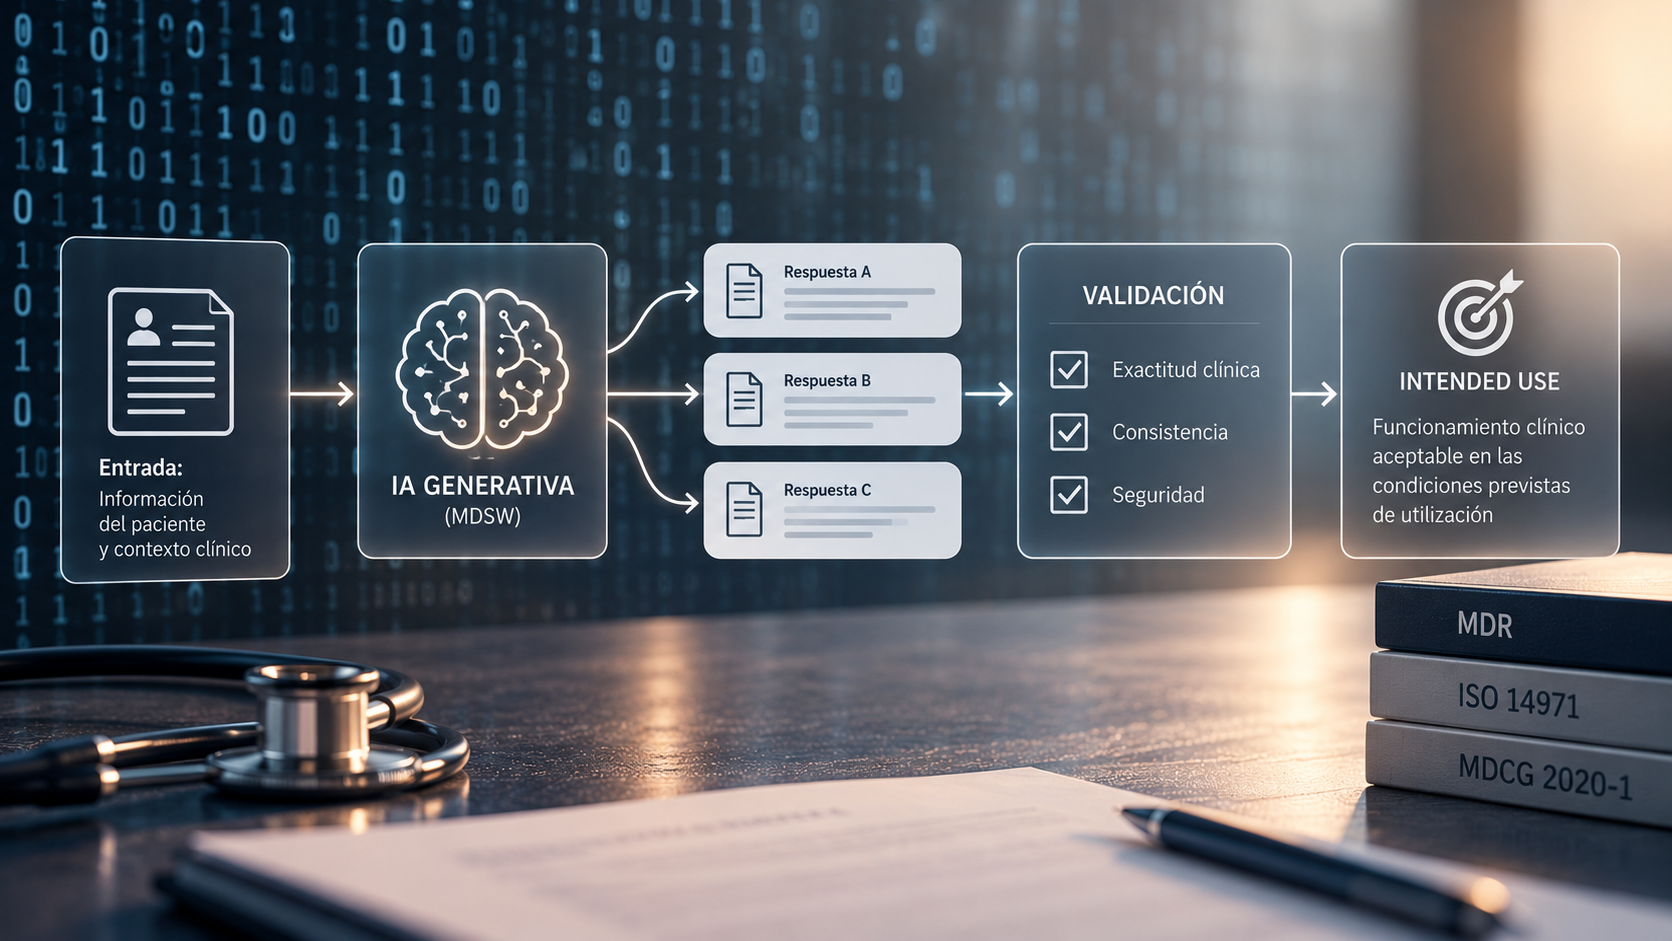
La validación de un producto sanitario software basado en inteligencia artificial generativa plantea una dificultad que no encontramos de la misma manera en el software determinista: una misma entrada puede producir respuestas diferentes sin que necesariamente exista un funcionamiento incorrecto.
En un software convencional podemos definir un resultado esperado y verificar que determinadas entradas producen las salidas especificadas. En IA generativa, exigir una correspondencia literal entre entrada y salida puede resultar técnicamente complicado.
Dos respuestas diferentes pueden ser clínicamente equivalentes, incluso diferentes. También pueden parecer similares y, sin embargo, conducir a decisiones terapéuticas distintas.
Por tanto, el problema no consiste en conseguir que el modelo responda siempre lo mismo, sino en demostrar que sus respuestas mantienen un funcionamiento clínico aceptable dentro de las condiciones previstas de uso.
Este planteamiento obliga a reconsiderar algunos métodos de verificación y validación, aunque no modifica las obligaciones fundamentales del MDR: ese es el reto.
El MDR exige repetibilidad, fiabilidad y funcionamiento conforme a la finalidad prevista
El requisito general de seguridad y funcionamiento 17.1 (RGSF) de MDR establece que los productos que incorporan sistemas electrónicos programables, incluido y principalmente el software, deben diseñarse para garantizar repetibilidad, fiabilidad y funcionamiento conforme a su finalidad prevista.
Por su parte, el RGSF 17.2 exige desarrollar el software conforme al estado del arte, considerando el ciclo de vida, la gestión de riesgos, la seguridad de la información y las actividades de verificación y validación.
Estas obligaciones siguen siendo aplicables a los sistemas generativos. Es ahí donde debemos idear la estrategia para garantizar el cumplimiento teniendo en cuenta las diferencias con tecnologías anteriores.
La dificultad aparece al interpretar qué significa repeatability cuando el funcionamiento previsto admite múltiples respuestas correctas.
Debemos distinguir entre repetibilidad del resultado textual y repetibilidad del funcionamiento clínico.
Un MDSW puede generar dos outputs diferentes sobre una misma situación clínica y mantener un funcionamiento consistente si ambas cumplen los requisitos especificados. Este es el concepto más importante de esta discusión.
Pero no sería aceptable que una respuesta recomendase una actuación terapéutica y otra la contradijese cuando ambas parten de la misma información clínica y no existe una justificación válida para esa diferencia, sobre todo, una justificación objetiva.
Por tanto, la validación debe establecer qué variabilidad resulta admisible y cuál constituye un incumplimiento de los requisitos de seguridad y funcionamiento.
Los criterios de aceptación deben definirse antes de ejecutar la validación
En sistemas deterministas, los criterios de aceptación suelen expresarse mediante resultados concretos esperados, tolerancias o intervalos de confianza definidos.
En IA generativa necesitamos ampliar este planteamiento, no tanto cambiarlo. Consideremos un MDSW destinado a proporcionar recomendaciones clínicas (por ejemplo, soporte al diagnóstico) a partir de información estructurada del paciente.
La validación no debería limitarse a comparar cada respuesta con un texto de referencia, por ejemplo un diagnóstico humano. Sería necesario establecer criterios relacionados con la información clínica relevante, las recomendaciones permitidas, las contraindicaciones, la incertidumbre y las situaciones en las que el sistema debe abstenerse de responder.
Podríamos distinguir tres niveles de aceptación:
1. Exactitud clínica. La información generada debe ser compatible con el conocimiento médico aplicable y con los datos disponibles del paciente.
2. Consistencia clínica. Las diferentes respuestas obtenidas ante una misma situación no deben introducir contradicciones clínicamente relevantes.
3. Seguridad del comportamiento. El sistema debe respetar sus límites funcionales, reconocer situaciones que requieren intervención profesional y evitar recomendaciones que puedan originar riesgos inaceptables.
Estos criterios deben traducirse en especificaciones verificables.
No basta con declarar que el modelo debe proporcionar respuestas médicamente correctas. Es necesario definir cómo se determinará esa corrección, quién la evaluará y qué resultados permitirán aceptar o rechazar el funcionamiento clínico.
La validación estadística debe considerar la variabilidad de los outputs
Cuando una misma entrada puede generar diferentes resultados, una única ejecución no permite caracterizar adecuadamente el comportamiento del sistema, sería irreal e impreciso.
Una estrategia metodológica razonable consiste en repetir las pruebas sobre conjuntos representativos de entradas y analizar la distribución de los resultados.
Esto permite evaluar tanto la frecuencia de respuestas aceptables como la aparición de comportamientos clínicamente relevantes no deseados.
Sin embargo, hay que evitar una simplificación: repetir muchas veces una entrada no demuestra por sí mismo que el producto sanitario MDSW sea clínicamente seguro.
El número de repeticiones, el tamaño muestral y los criterios estadísticos deben justificarse considerando la finalidad prevista, la gravedad de los posibles errores y la variabilidad observada. Esta es la dificultad, donde se habrá de demostrar la relación beneficio/riesgo.
Además, las observaciones repetidas sobre un mismo caso pueden estar correlacionadas, podrían conducir a un estado de sobre-entrenamiento u overfitting. No debe focalizarse en el volumen de datos sino en la representatividad clínica y estadística y en la confiabilidad del dato, en este aspecto el proceso de data management debe ser un proceso pivotal.
Para determinados outputs será posible calcular sensibilidad, especificidad, concordancia o tasas de error. Para otros, especialmente los que contienen recomendaciones abiertas, se van a necesitar criterios de evaluación específicos y, especialmente, límites concretos.
La FDA plantea precisamente esta dificultad en su documento de discusión de agosto de 2026 y pregunta cómo deberían establecerse comparadores, criterios de aceptación y mediciones estadísticamente significativas para outputs abiertos.
Los conjuntos de validación deben representar las condiciones reales de utilización
Una validación técnicamente correcta y precisa puede resultar poco representativa si los casos utilizados no reflejan las condiciones previstas de uso.
En IA generativa, esta cuestión adquiere especial importancia porque el funcionamiento puede variar según la formulación de las preguntas, la información disponible y el contexto de la interacción.
Por ello, los conjuntos de validación deberían contemplar tanto casos clínicos representativos como situaciones que puedan poner a prueba los límites funcionales del producto. Será especialmente crítico representar todos los casos previsibles para poder asemejar los resultados obtenidos con los esperados.
Entre otras, entradas incompletas, información contradictoria, formulaciones ambiguas, casos clínicos poco frecuentes y conversaciones sucesivas en las que el contexto se modifica progresivamente. Es en este punto donde, personalmente, recobro la esperanza y pienso que, en realidad, la validación podría no ser tan diferente.
También debe justificarse la independencia entre los datos utilizados para desarrollar o ajustar el sistema y aquellos empleados para evaluar su funcionamiento.
La contaminación de los conjuntos de ensayo puede producir estimaciones artificialmente favorables. Esto es especialmente significativo porque ahora el proceso de validación deberá ser pulcramente preciso y exigente.
Este problema resulta especialmente relevante cuando utilizamos modelos fundacionales entrenados con grandes volúmenes de información cuyo contenido completo no conocemos o no podemos garantizar su extrema precisión, tanto en términos clínicos, como estadísticos.
Un buen resultado sobre un conjunto público de preguntas médicas no demuestra necesariamente que el producto funcione adecuadamente en su entorno clínico previsto.
La FDA ha identificado expresamente los problemas de contaminación, representatividad y validez de los benchmarks como cuestiones que requieren atención en la evaluación de productos sanitarios con IA generativa.
La evaluación humana debe contar con criterios reproducibles
Cuando los outputs son abiertos, la evaluación por profesionales sanitarios puede resultar necesaria. Sin embargo, incorporar especialistas a la validación no garantiza automáticamente la objetividad del proceso, tampoco la suficiente representatividad clínica.
Debemos establecer previamente qué aspectos evaluarán, qué criterios utilizarán y cómo se resolverán las discrepancias.
Por ejemplo, un panel de profesionales podría valorar la corrección clínica, la relevancia de la información, la presencia de recomendaciones potencialmente peligrosas y la adecuación del resultado a la finalidad prevista.
La metodología debería contemplar la independencia de los evaluadores, su experiencia, las instrucciones recibidas y los procedimientos de adjudicación.
También será necesario determinar si el comparador adecuado es una referencia clínica previamente establecida, el consenso de especialistas o el funcionamiento esperado de los usuarios previstos.
No son alternativas necesariamente equivalentes.
En determinados productos, además, puede resultar más representativo evaluar el funcionamiento conjunto del profesional y el software que analizar exclusivamente las respuestas generadas por el algoritmo. En mi opinión, será en este punto donde más rendimiento y seguridad se obtenga.
MDCG 2020-1 establece que la validación del clinical performance debe considerar la finalidad prevista, la población objetivo, las condiciones y entornos de uso y los grupos de usuarios previstos.
La validación debe realizarse sobre la configuración real del producto
Otro aspecto importante es identificar qué estamos validando exactamente. En un MDSW con IA generativa, el resultado puede depender de varios componentes:
- Modelo fundacional
- Versión
- Parámetros de configuración
- Instrucciones del sistema
- RAG
- Mecanismos de control
- Interfaz de usuario.
Validar únicamente el modelo fundacional no supone en sí mismo validar el producto sanitario terminado.
Una modificación del system prompt puede alterar las recomendaciones. Una actualización de las fuentes utilizadas por RAG puede modificar las respuestas. Un cambio de versión del modelo puede introducir comportamientos que no estaban presentes durante la validación inicial.
Por tanto, la documentación de diseño y desarrollo debe identificar la configuración validada y establecer mecanismos que permitan controlar los cambios.
La evaluación del impacto de una modificación deberá determinar qué actividades de verificación y validación necesitan repetirse.
Esto resulta especialmente importante cuando determinados componentes dependen de proveedores externos, pero este aspecto también debe integrarse en el proceso porque se trata de un enfoque irreversible.
La validación clínica no podrá sustituirse por un benchmark técnico
Los resultados de un benchmark pueden proporcionar información valiosa sobre determinadas competencias del sistema. Pero debemos distinguir entre demostrar que un modelo responde correctamente a preguntas médicas y demostrar que un producto sanitario alcanza eficazmente su finalidad prevista (validación).
Un sistema puede obtener resultados excelentes en pruebas generales de conocimiento clínico y presentar dificultades cuando se utiliza con información incompleta, usuarios menos experimentados o situaciones clínicas distintas de las representadas en los ensayos.
MDCG 2020-1 diferencia la Valid Clinical Association, el Technical Performance y el Clinical Performance como elementos de la generación de evidencia para MDSW.
La validación técnica puede contribuir a demostrar el funcionamiento del software, pero no sustituye automáticamente la evidencia necesaria para establecer su funcionamiento clínico.
La FDA también distingue, en su propuesta conceptual de evaluación basada en competencias, entre la evaluación mediante benchmarks y la confirmación clínica del funcionamiento. Es necesario recordar que su documento de agosto de 2026 es un texto de discusión y no establece nuevos requisitos regulatorios definitivos.
Validar IA generativa significa demostrar un funcionamiento clínico
La validación de IA generativa no debería perseguir una reproducibilidad textual absoluta cuando esta no resulta necesaria para la finalidad prevista.
Pero tampoco podemos aceptar la variabilidad como una justificación de una propiedad tecnológica que justifique cualquier diferencia de comportamiento.
El fabricante debe definir qué resultados son clínicamente aceptables, qué variaciones pueden producirse sin comprometer el funcionamiento y qué comportamientos constituyen fallos y podrían afectar la seguridad.
Después tendrá que demostrar, mediante evidencia objetiva y una metodología estadísticamente justificada, que el producto satisface esos criterios en condiciones representativas de utilización.
Se deberá mantener esa demostración durante todo el ciclo de vida mediante el control de cambios y el seguimiento poscomercialización.
La variabilidad de las respuestas no impide validar una IA generativa. Lo que impide una validación rigurosa es no haber definido previamente qué significa que esas respuestas sean clínicamente adecuadas, consistentes y seguras.